L’avvento dei Large Language Model multimodali ha avuto un impatto significativo sui processi di gestione documentale che caratterizzano i workflow operativi di molte aziende. Nei contesti di dimensione enterprise la sfida più importante non è la semplice estrazione del testo presente in un documento scansionato, ma la sua trasformazione in dati strutturati, affidabili, verificabili e utilizzabili all’interno del sistema informativo aziendale.
Un caso d’uso particolarmente critico, che ci siamo trovati più volte ad affrontare, riguarda gli adempimenti KYC, KYB e AML. Si tratta di contesti in cui la semplice estrazione di un nome, di una data o di una percentuale non è sufficiente a completare il processo: occorre comprendere il significato di quei valori, a quale soggetto si riferiscono, da quale documento provengono e con quale livello di affidabilità possano essere usati per far avanzare la pratica.
Per anni il termine OCR è stato considerato alla stregua di un sinonimo di automazione documentale. Negli ultimi anni i Vision LLM e, più in generale, i sistemi di Document Intelligence hanno contribuito a spostare il focus dalla pura trascrizione del testo alla comprensione del documento nel suo insieme: layout, relazioni tra campi, tabelle, firme, timbri, checkbox, coerenza semantica e qualità dell’evidenza.
È tuttavia importante non incorrere in una semplificazione fuorviante: i Vision LLM non sono una tecnologia sostitutiva dell’OCR classico. Nei progetti reali che abbiamo sviluppato negli ultimi due anni lo scenario più efficace è quasi sempre risultato quello di un’architettura ibrida, in cui OCR tradizionale, parser documentali, modelli multimodali, regole deterministiche e human review collaborano all’interno dello stesso workflow.
In questo articolo proponiamo una lettura pragmatica del tema e un framework utilizzabile per impostare correttamente la progettazione di sistemi documentali realmente affidabili in produzione.
Un documento leggibile non è ancora un dato affidabile
Un sistema può riconoscere correttamente la stringa 37% e tuttavia non aver ancora raggiunto il proprio obiettivo funzionale. In un documento societario quella percentuale potrebbe indicare una quota diretta, una quota indiretta, una partecipazione storica, una classe di azioni o un valore riferito a un soggetto diverso da quello atteso.
La differenza fra una semplice lettura e una vera comprensione documentale sta proprio in questa interpretazione. Un workflow enterprise non deve solo rispondere alla domanda «quale testo compare sulla pagina?», ma deve essere in grado di rispondere anche a quesiti semanticamente più rilevanti:
- che cosa significa questo valore;
- a quale entità si riferisce;
- in quale parte del documento compare;
- quanto è affidabile l’estrazione;
- quali controlli sono stati già effettuati;
- se il dato può essere usato automaticamente oppure richiede una review umana.
La qualità dell’automazione di un processo regolato si misura, infatti, dalla capacità di produrre evidenze strutturate e verificabili più che dalla qualità dell’OCR.
Cosa cambia dall’OCR ai Vision LLM
L’OCR nasce per riconoscere i singoli caratteri di un testo. Quando le condizioni sono buone e il documento è relativamente standardizzato è una tecnologia di straordinaria utilità: è veloce, economica, deterministica e, nella maggior parte dei casi, non genera informazioni inesistenti.
Un Vision Language Model, al contrario, combina informazione visiva e linguistica. Non effettua una semplice estrazione dei caratteri contenuti nel testo, ma cerca di interpretare contemporaneamente più elementi di valore sintattico e semantico:
- struttura della pagina;
- relazioni spaziali fra blocchi e campi;
- contesto semantico;
- tabelle;
- grafici;
- elementi non testuali come firme, timbri e checkbox.
Gli LLM sono sistemi che nativamente estraggono ed elaborano informazioni sulla posizione dei token — quindi degli elementi di testo: parole, sillabe, acronimi — sulle relazioni con gli altri elementi presenti nella pagina e sul tipo di documento in cui il testo compare.
L’estrazione del testo non avviene per semplice classificazione dei segni presenti nell’immagine, ma è il risultato di un processo inferenziale generativo, caratteristico degli LLM.
La maggiore potenza e versatilità di questa tecnologia risiede proprio nella sua natura, ma il rovescio della medaglia è che l’informazione estratta potrebbe in alcuni casi essere apparentemente inventata, per effetto dei fenomeni definiti allucinazioni: anche questi caratteristici degli LLM e, soprattutto, impossibili da prevenire in modo totale.
OCR: un lettore eccellente, ma non sempre un interprete sufficiente
L’OCR continua a eccellere in tutti i casi in cui il problema è soprattutto di puro riconoscimento testuale:
- moduli ripetitivi;
- layout molto stabili;
- grandi volumi con vincoli di costo e latenza;
- ambienti offline o a forte requisito di data residency;
- processi in cui serve prevedibilità dell’output.
Il limite emerge quando il documento fuoriesce da questi binari: scansioni degradate, tabelle complesse, campi ambigui, layout variabili, relazioni semantiche non esplicitate in modo uniforme.
Vision LLM: struttura e contesto oltre al testo
I Vision LLM forniscono una capacità che l’OCR puro non possiede in modo nativo: capire il documento come oggetto strutturato.
Un Vision LLM può riconoscere che una certa stringa è un nome di persona, che una data è una data di costituzione, che una percentuale esprime una quota societaria e che due blocchi di testo appartengono alla stessa sezione logica.
Per questo motivo il loro contributo diventa prezioso nei processi in cui è necessario estrarre dati strutturati da documenti non standardizzati.
OCR e Vision LLM non sono antitetici
La domanda corretta non è: «Quale tecnologia è migliore?»
La domanda corretta è: «Quale tecnologia ha senso usare per questo tipo di documento, in questa lingua, a questo costo, con questo livello di rischio e con questo bisogno di auditabilità?»
Perché KYC, KYB e AML sono il banco di prova perfetto
I workflow KYC e KYB rappresentano probabilmente il test più severo per una pipeline di Document Intelligence, perché presentano, nello stesso processo, quasi tutte le criticità possibili.
In uno scenario reale KYC/AML devono essere gestiti:
- documenti di identità;
- prove di residenza;
- certificati di registrazione;
- estratti di registro;
- statuti;
- registri soci;
- dichiarazioni di beneficial ownership;
- procure;
- atti societari eterogenei;
- screening sanzioni e PEP;
- verifiche su catene di controllo e ownership.
A questo si aggiungono tre ulteriori complicazioni, che nel quadro degli adempimenti antiriciclaggio pesano quanto la norma stessa.
1. I documenti sono differenti da Paese a Paese
La stessa informazione può comparire in formati radicalmente diversi a seconda della giurisdizione. Un estratto societario francese, un Handelsregister tedesco, un certificate of incorporation anglosassone o un documento asiatico di business registration non condividono la stessa struttura, la stessa terminologia e nemmeno la stessa convenzione grafica.
L’Europa ha compiuto passi importanti verso l’interconnessione dei registri d’impresa — il sistema BRIS permette di cercare una società in tutti gli Stati membri da un unico punto di accesso — ma l’accesso ai dati non equivale a una piena armonizzazione documentale. In pratica i workflow enterprise continuano a confrontarsi con documenti nazionali, lingue locali e formati profondamente eterogenei.
2. Le informazioni rilevanti sono relazionali
Nel KYC e nel KYB non basta estrarre campi indipendenti. Occorre ricostruire relazioni:
- chi controlla chi;
- chi è amministratore e chi è azionista;
- quali quote si moltiplicano lungo una catena partecipativa;
- chi rientra o meno nella soglia UBO;
- se i dati presenti in più documenti sono coerenti tra loro.
La sola lettura dei caratteri non è in questo caso sufficiente: occorre la comprensione del contesto.
3. L’auditabilità è parte del risultato
In un processo AML il dato estratto non è utile se non può essere ricondotto con chiarezza alla sua fonte. Un operatore deve poter verificare rapidamente:
- da quale documento arriva il dato;
- in quale pagina si trova;
- se il ritaglio o bounding box è corretto;
- quale confidence è stata attribuita;
- quali regole di controllo sono state applicate;
- perché il sistema ha deciso di accettare, respingere o inviare il caso in review.
In altre parole, nei processi regolati l’output utile è il valore più la prova.
Il vero problema multilingua non è il numero di lingue supportate
Molti vendor dichiarano la copertura di decine o perfino centinaia di lingue. È un’informazione utile, ma non sufficiente per valutare la tecnologia.
Il vero punto critico è come il sistema si comporta sui documenti reali delle giurisdizioni che compongono il portafoglio aziendale.
Questa distinzione è essenziale per un’azienda multinazionale. Un benchmark medio in inglese non predice automaticamente il comportamento su:
- arabo;
- cinese;
- giapponese;
- coreano;
- hindi e altri script indici;
- documenti misti con testo latino e non latino;
- scansioni reali degradate;
- documenti con font inconsueti o stampa di bassa qualità.
Ma soprattutto non dice nulla sulla capacità di trattare documenti strutturati secondo usi e convenzioni locali.
Le evidenze emerse nel 2026 sui benchmark dedicati agli script sotto-rappresentati mostrano proprio questo: modelli apparentemente molto forti in contesti mainstream possono degradare drasticamente quando si passa a documenti reali in lingue e scritture meno frequenti.
Per un’organizzazione internazionale la lezione è chiara: non si deve valutare il sistema sui documenti ideali, ma sul long tail documentale reale.
OCR o Vision LLM? È la domanda sbagliata
Nei workflow enterprise la domanda più utile non è se scegliere OCR o Vision LLM, ma come progettare il routing.
Un’architettura ben progettata non può affidarsi a un modello universale capace di fare tutto: richiede l’analisi, per ogni classe documentale, del percorso di elaborazione più efficiente e più affidabile.
Uno schema semplificato che deriva dalle nostre esperienze è il seguente:
- classificare il documento;
- riconoscere formato, lingua e qualità dell’input;
- scegliere la pipeline più adatta;
- estrarre i dati secondo uno schema;
- validare i risultati;
- calcolare confidence e rischio;
- decidere se proseguire automaticamente o coinvolgere un operatore.
Questo significa, ad esempio, che:
- un PDF nativo può essere gestito con parsing diretto;
- un modulo molto stabile può seguire una pipeline OCR classica;
- una tabella nota può essere letta con un parser deterministico;
- un documento inconsueto o poco standardizzato può essere instradato verso un Vision LLM;
- un caso con confidence bassa o incongruenze può essere inviato a human review.
In questa prospettiva il vero fattore distintivo non è il singolo modello, ma l’orchestrazione.
L’architettura che funziona in produzione è ibrida
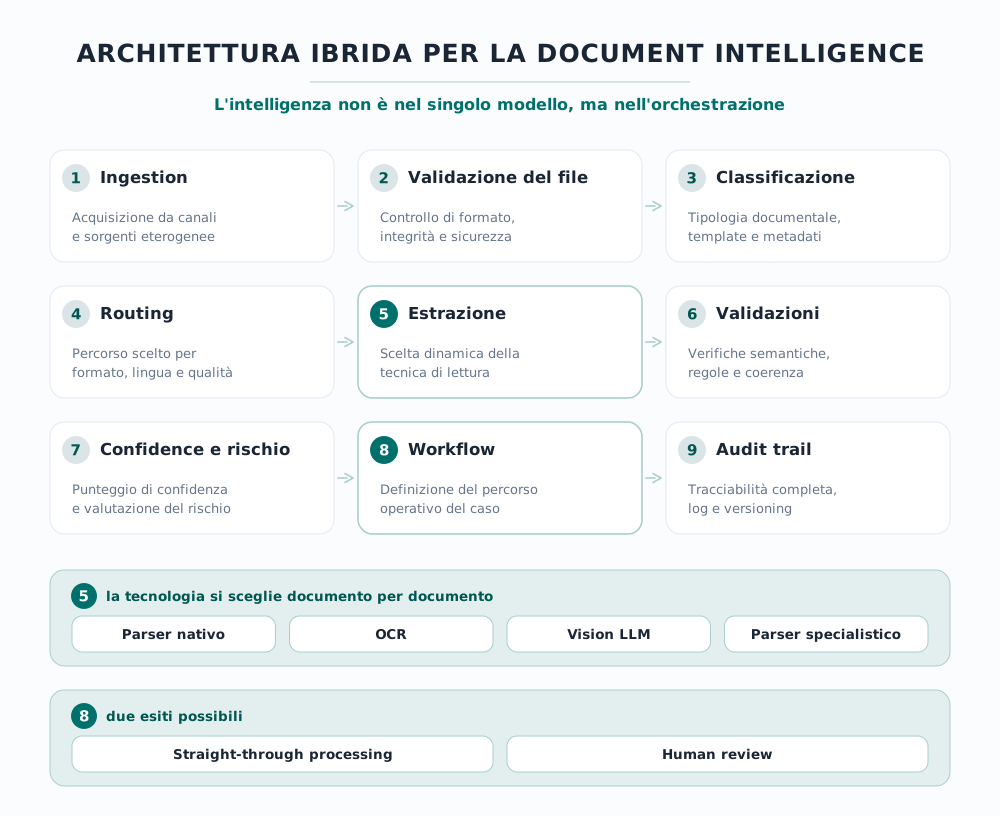
La ricerca e la nostra esperienza di produzione convergono su un punto: i sistemi più efficaci tendono a essere ibridi. Uno studio del 2025 su documenti d’identità ripetitivi mostra che l’accoppiamento fra un motore OCR e un LLM raggiunge un F1 pari a 1,0 con 0,97 secondi di latenza sui documenti strutturati, mentre l’approccio puramente multimodale resta molto più lento a parità di risultato.
Un’architettura di Document Intelligence per KYC/AML può essere descritta come una sequenza di componenti specializzati:
- Ingestion e validazione del file
- Classificazione documentale
- Routing per formato, lingua e qualità
- Parsing con tecnologia appropriata
- parser nativo;
- OCR;
- Vision LLM;
- parser specialistico.
- Estrazione schema-driven
- Validazioni deterministiche
- Cross-check con fonti esterne o altri documenti
- Confidence e risk scoring
- Straight-through processing oppure human review
- Persistenza dell’audit trail
Questa impostazione offre diversi vantaggi concreti.
Massimizza il rapporto tra costo e affidabilità
L’OCR tradizionale risulta spesso imbattibile su throughput, costo marginale e prevedibilità. I Vision LLM diventano preziosi quando la variabilità documentale e semantica rende inefficaci o troppo costose le sole regole basate su template.
Usare sempre il modello più sofisticato non è necessariamente la scelta migliore. Nei volumi enterprise è molto più sensato usare il modello più costoso solo quando aggiunge davvero valore.
Riduce la fragilità dei template
I sistemi basati soltanto su template possono essere estremamente efficaci finché il documento rimane stabile, ma diventano una soluzione fragile nel momento in cui il layout risulta variabile. I Vision LLM possono diventare la componente che assorbe la variabilità, lasciando alle regole deterministiche il controllo dei passaggi più sensibili.
Permette di gestire il long tail
Il problema più difficile nei workflow documentali è il cosiddetto long tail: documenti rari, scansioni imperfette, formati inattesi, combinazioni linguistiche poco frequenti, casi incompleti. L’architettura ibrida consente di trattare questi casi senza costringere tutta la pipeline a funzionare allo stesso modo per ogni documento.
Read, Understand, Prove: il framework per progettare Document Intelligence
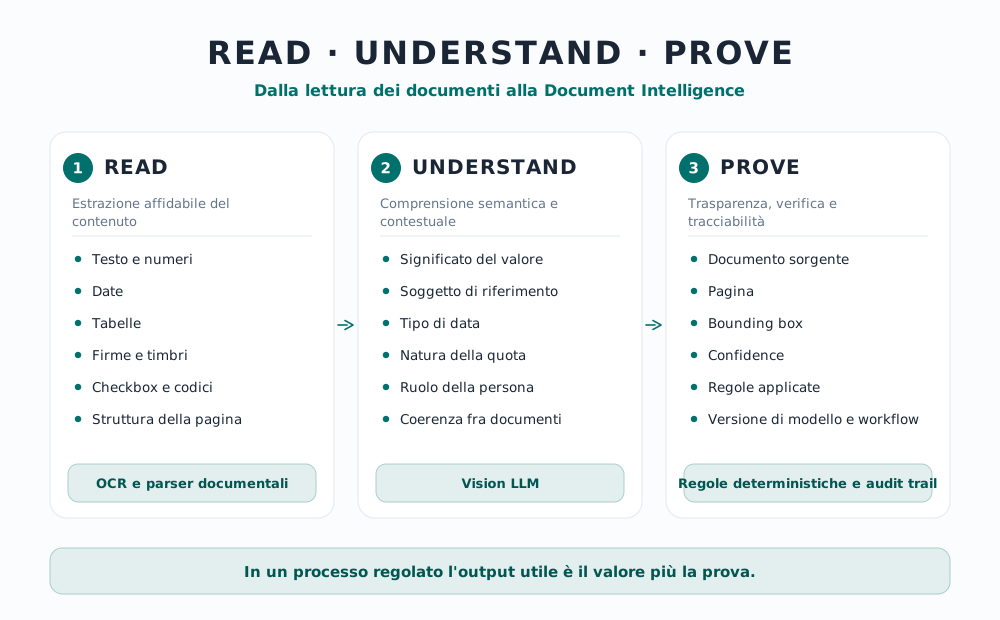
Per evitare l’eccesso di hype può essere utile ridurre il problema a tre verbi molto semplici.
1. Read
Il sistema deve leggere il documento e riconoscerne gli elementi fondamentali:
- testo;
- numeri;
- date;
- tabelle;
- firme;
- timbri;
- checkbox;
- codici a barre o QR;
- struttura di base della pagina.
In questo ambito le tecnologie più efficaci sono OCR e parser documentali.
2. Understand
Il sistema deve comprendere il significato dei dati letti:
- che cosa rappresenta il valore;
- a quale soggetto si riferisce;
- se la data è di emissione, scadenza o costituzione;
- se una percentuale indica possesso, controllo o un’altra nozione;
- se una persona è amministratore, socio o rappresentante legale;
- se più documenti raccontano una storia coerente.
In questo caso il contributo più rilevante è offerto dai Vision LLM.
3. Prove
Il sistema deve infine trasformare l’estrazione in una evidenza verificabile:
- documento sorgente;
- pagina;
- bounding box o ritaglio;
- confidence;
- regole di validazione applicate;
- eventuale revisione umana;
- versione del modello e del workflow.
Non è un requisito teorico: i motori di ultima generazione restituiscono già oggi una rappresentazione strutturata del documento, con ogni blocco localizzato da un bounding box, classificato per tipo e accompagnato da un punteggio di confidence per pagina.
Questo terzo livello è quello che rende un sistema realmente utilizzabile in un contesto regolato. L’output atteso da un’applicazione enterprise non dovrebbe essere semplicemente:
beneficial_owner = Mario Rossiownership = 37%
ma dovrebbe contenere indicazioni come:
- da quale documento proviene il dato;
- in quale punto della pagina è stato trovato;
- con quale confidenza è stato estratto;
- se il dato è coerente con altri documenti;
- se la pratica può procedere senza intervento umano.
Nella progettazione di una pipeline documentale diventa quindi fondamentale porsi una domanda pratica: quale percentuale dell’output è supportata da un’evidenza facilmente ricostruibile?
Un documento è anche un input non fidato
Un elemento da non trascurare è che nei workflow KYC il documento proviene dall’esterno. Per definizione va quindi considerato come un input non fidato.
Questo significa che ogni file dovrebbe essere trattato anche come un possibile vettore di errore, ambiguità o attacco, oltre che come semplice fonte di dati.
Nel mondo dei modelli generativi i rischi più discussi sono:
- allucinazioni;
- errori su nomi propri, numeri e date;
- non determinismo;
- interpretazioni strutturali plausibili ma errate;
- prompt injection indiretta veicolata attraverso contenuti esterni.
L’ultimo punto non è teorico: la prompt injection è la prima voce della classifica OWASP dei rischi delle applicazioni LLM, e la variante indiretta è proprio quella che passa da contenuti esterni come file e documenti. Per questa ragione è bene fissare un principio semplice:
Il contenuto di un documento deve essere trattato come dato, non come istruzione.
E un secondo principio, ancora più operativo:
Un componente autorizzato a leggere un documento non deve acquisire automaticamente l’autorità per agire su sistemi aziendali o basi dati sensibili.
Da questi principi derivano alcune scelte architetturali improntate al rafforzamento della sicurezza:
- separare estrazione e azione;
- limitare i privilegi dei componenti che processano documenti;
- usare output strutturati e validati;
- introdurre controlli deterministici prima di qualsiasi automazione sensibile;
- prevedere approvazione umana per i passaggi ad alto impatto.
Nei workflow regolati la sicurezza deve essere parte integrante del progetto della pipeline.
Human in the loop non significa tornare al lavoro manuale
Una delle obiezioni più frequenti è questa: se il risultato deve comunque essere controllato da un operatore, qual è il vantaggio?
La risposta è che human in the loop non significa controllare tutto. Significa controllare solo ciò che merita davvero attenzione.
L’automazione crea valore quando riesce a distinguere in modo affidabile tre categorie:
- casi semplici e sufficientemente certi, che possono procedere automaticamente;
- casi incerti, che richiedono una verifica veloce;
- casi anomali o ad alto rischio, che richiedono una review approfondita.
Le soglie dovrebbero dipendere dal rischio del dato oltre che dalla confidence tecnica del modello. Un CAP letto con confidenza del 92% non ha lo stesso impatto di un beneficiario effettivo o di una quota societaria determinante per la classificazione UBO.
La maturità progettuale della soluzione si misura da questi elementi: definizione di soglie, eccezioni, escalation e modalità di review che riducano il lavoro manuale senza compromettere il controllo.
Come si valuta una pipeline Vision LLM/OCR
Uno degli errori più comuni è limitarsi a metriche generiche di accuratezza oppure a benchmark pubblici considerati in modo superficiale. In produzione occorrono invece metriche specifiche, aderenti al processo reale.
Alcuni KPI davvero utili
Esempi di indicatori di performance adeguati sono:
- Field precision / recall: quanto sono corretti i singoli campi.
- Document-type accuracy: quanto bene il sistema classifica il documento.
- Schema completeness: quanti campi obbligatori vengono effettivamente restituiti.
- Cross-document consistency: quanto sono coerenti i dati tra più fonti.
- Human-review rate: quante pratiche richiedono intervento umano.
- Straight-through processing rate: quante pratiche procedono end-to-end in automatico.
- Accuracy by language: come varia la qualità per lingua o script.
- Accuracy by jurisdiction: come varia la qualità per Paese.
- Accuracy by document type: dove si concentra il long tail degli errori.
- Catastrophic error rate: quanto spesso il sistema produce errori gravi.
- Cost per processed case: non solo costo per pagina o per token, ma costo reale per pratica.
- P95 latency: prestazione operativa sui casi reali.
- Model/version drift: stabilità nel tempo dopo aggiornamenti di modello o workflow.
Una metrica che merita attenzione: l’evidenza
In molti contesti regolati una pipeline non dovrebbe essere valutata solo per ciò che estrae, ma anche per quanto bene riesce a dimostrare l’origine dell’informazione estratta.
Per questo, oltre alle metriche classiche, è utile introdurre un criterio come l’evidence coverage: la quota di output per cui il sistema conserva una prova facilmente ricostruibile e verificabile.
I benchmark pubblici vanno letti con prudenza
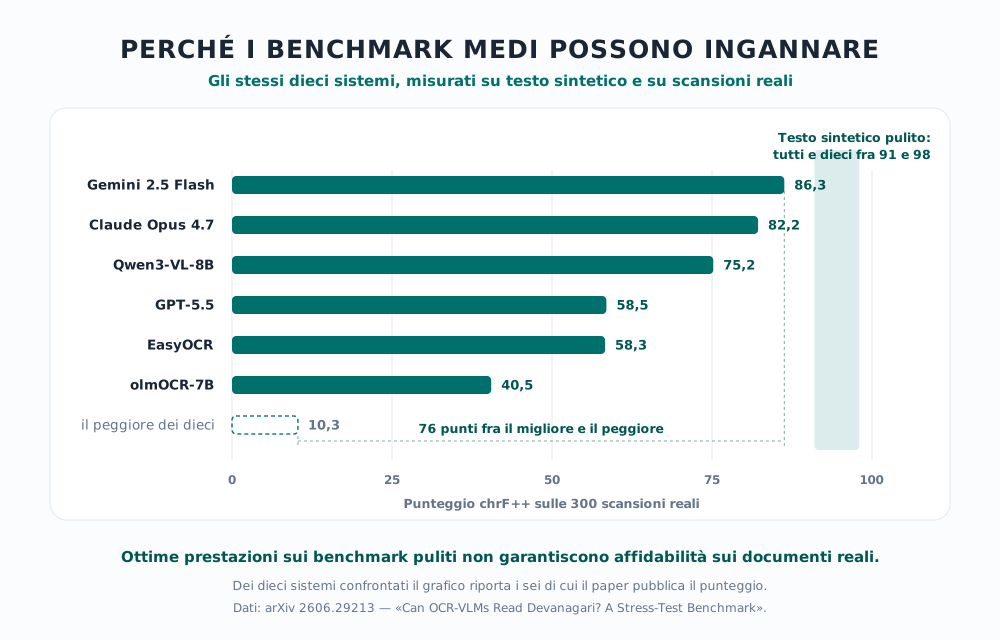
Benchmark come OCRBench v2 e gli studi più recenti sul comportamento dei modelli su documenti reali e script sotto-rappresentati sono molto utili per orientarsi, ma non sostituiscono la regola elementare secondo cui il sistema va provato sui propri documenti reali.
Lo studio del 2026 sul devanagari è un buon esempio di quanto il divario possa essere ampio: i dieci sistemi confrontati — dal classico EasyOCR ai modelli multimodali di frontiera — si collocano tutti fra 91 e 98 punti chrF++ sul testo sintetico pulito, ma sulle 300 scansioni reali nove su dieci crollano e il campo si distribuisce su un intervallo di 76 punti. Lo stesso lavoro segnala che una buona capacità di OCR in inglese non predice il comportamento sugli script indici.
Una media globale può quindi nascondere proprio gli errori che pesano di più nel contesto aziendale specifico.
AI Act, AML e governance: niente scorciatoie
Quando si parla di AI applicata al KYC è facile incorrere in semplificazioni eccessive, soprattutto sul piano regolatorio.
La prima è pensare che qualunque uso dell’AI nel KYC equivalga automaticamente a un sistema high-risk. In realtà la classificazione dipende dall’intended purpose del sistema e dal ruolo concreto che esso svolge nel processo: l’Allegato III dell’AI Act elenca otto ambiti, e un motore di estrazione documentale non vi rientra per il solo fatto di usare un modello.
La seconda semplificazione è immaginare che il vero tema sia soltanto la conformità normativa futura — peraltro non così lontana, visto che l’applicazione delle regole sui sistemi ad alto rischio dell’Allegato III scatta il 2 dicembre 2027. In realtà molte organizzazioni hanno già oggi esigenze molto concrete di:
- tracciabilità;
- versioning dei modelli;
- documentazione delle regole;
- controllo del cambiamento;
- supervisione umana;
- explainability operativa.
Non è un tema solo interno. La Vigilanza bancaria della BCE, esaminando l’uso dell’AI nelle banche europee, ha osservato che alcune istituzioni non hanno piena trasparenza sui processi interni di certi modelli: esattamente il punto su cui una pipeline documentale ben progettata può fare la differenza.
Per questo motivo è più utile affrontare il tema in termini di governance del sistema che non di slogan. Un’architettura ben progettata dovrebbe permettere di sapere:
- che cosa ha fatto il sistema;
- con quale versione dei modelli;
- con quali evidenze;
- con quali regole di validazione;
- con quale intervento umano, se presente.
Questo approccio costituisce la base minima per usare l’AI in modo realmente efficace all’interno di workflow documentali regolati.
Che cosa cambia davvero per una multinazionale
Il problema delle organizzazioni multinazionali non risiede nel fatto che il volume dei documenti è molto più elevato che nelle organizzazioni di minori dimensioni, ma nella loro maggiore variabilità.
Il volume si gestisce scalando la capacità di elaborazione; la variabilità, che è una conseguenza diretta del carattere multinazionale di queste organizzazioni, è invece un problema di tipo applicativo e funzionale.
In una multinazionale aumentano:
- i tipi documentali;
- le eccezioni nazionali;
- le lingue e gli script;
- i casi incompleti o degradati;
- i vincoli di compliance e data residency;
- la necessità di standardizzare output provenienti da input profondamente eterogenei.
In questo contesto la soluzione non consiste nel leggere «un po’ meglio» ogni singola pagina, ma nella capacità di ridurre la dipendenza da un numero eccessivo di parser, regole e template specifici per Paese. È qui che i modelli multimodali mostrano appieno il proprio valore.
In altre parole: il beneficio reale emerge quando il sistema riesce a gestire più variabilità senza perdere controllo. I modelli multimodali vengono utilizzati per gestire il disordine del mondo reale; regole, validazioni e review servono a mantenere affidabilità, auditabilità e governance.
Conclusione: il modello con il benchmark più alto non è la soluzione migliore
Il passaggio dall’OCR alla Document Intelligence non consiste nel sostituire un motore di riconoscimento con un modello più grande.
Consiste nel progettare una pipeline in grado di:
- scegliere come trattare ogni documento;
- leggere testo e struttura;
- comprendere il significato dei dati;
- produrre evidenze verificabili;
- attivare controlli deterministici;
- instradare i casi incerti verso human review;
- mantenere costi, latenza e governance entro vincoli compatibili con la produzione.
Per questo motivo, nella progettazione dei workflow KYC/AML complessi, non è di grande utilità valutare quale modello sia momentaneamente in testa a un benchmark.
La domanda più utile che un progettista dovrebbe porsi è un’altra:
Il sistema riesce a produrre dati corretti, verificabili e governabili sui documenti reali con cui l’organizzazione lavora ogni giorno?
Se la risposta è affermativa, allora la soluzione ipotizzata è correttamente definibile come Document Intelligence progettata per funzionare in produzione.
È il terreno su cui lavoriamo con i nostri servizi di intelligenza artificiale: partire dai documenti reali, dai volumi operativi e dai requisiti di controllo del processo, prima ancora che dal modello.